ReconAgent
Em desenvolvimentoAgente que concilia e-mails de confirmação de operações com o sistema interno, com avaliação offline e fila de revisão humana.
- 3
- provedores: regex, Claude e GPT
Visão geral
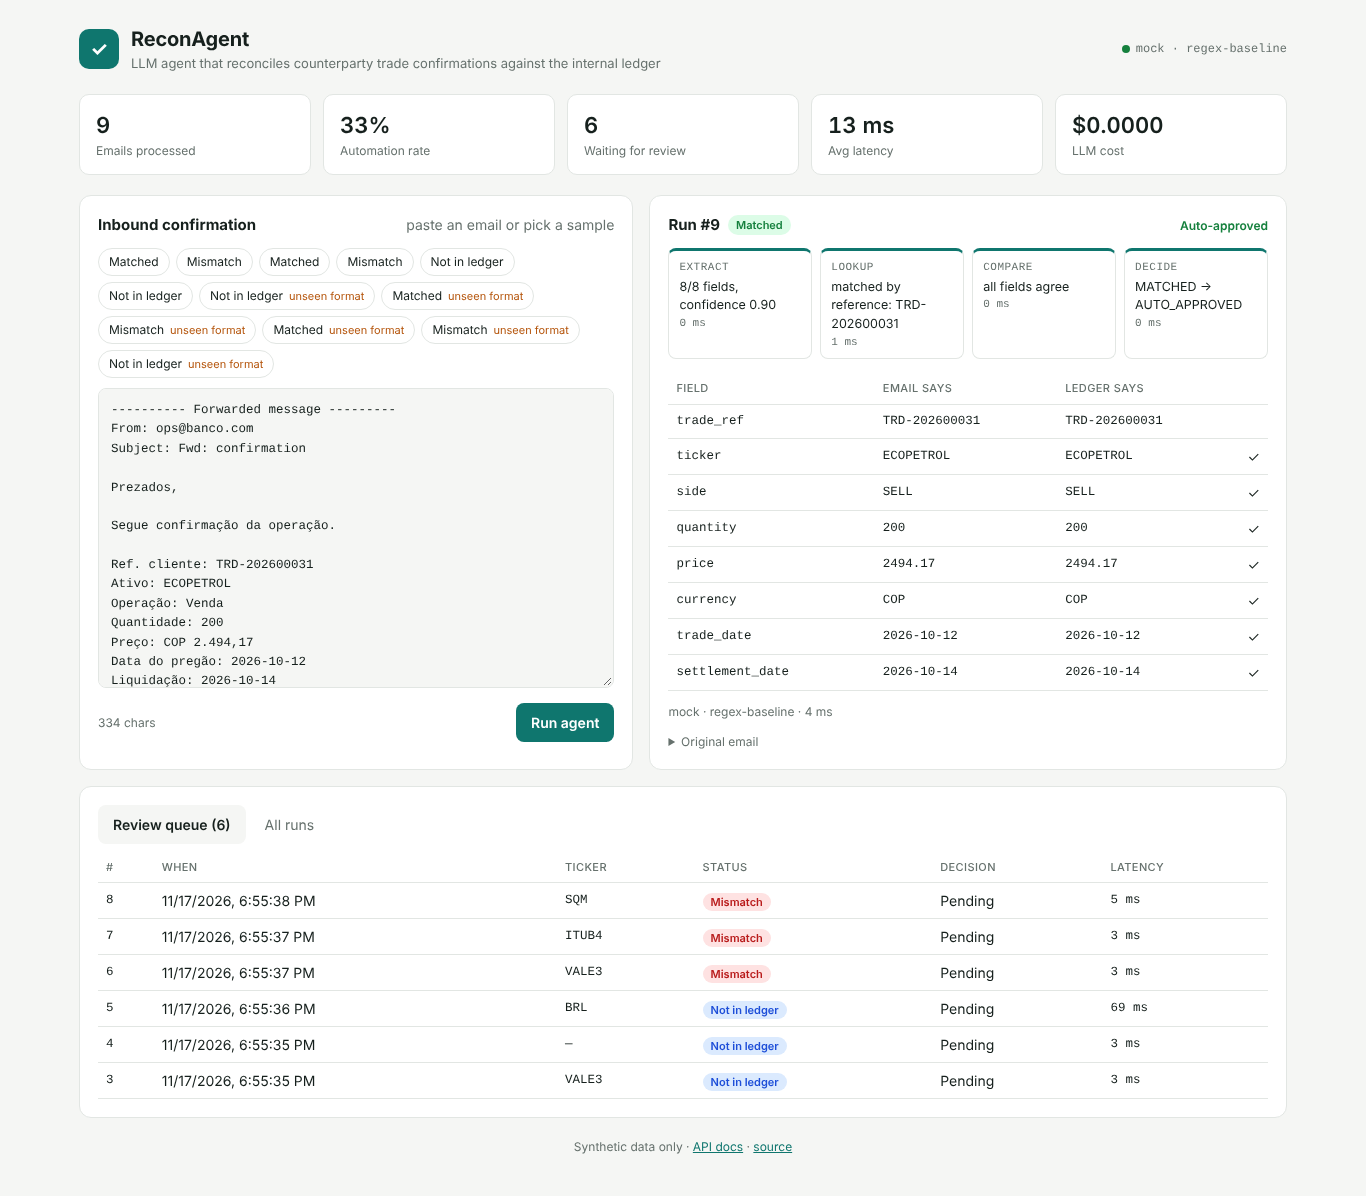
É um protótipo com dados sintéticos inspirado no revisor de e-mails que construí no BTG. Uma mesa de operações recebe confirmações em três idiomas e formatos variados; o agente lê cada uma, encontra a operação registrada e decide se aprova sozinho ou manda para um analista.
O foco é mostrar como medir um sistema com LLM: cada mudança de modelo ou de prompt passa por um conjunto de casos com resposta conhecida.
O que ele faz
- Grafo de quatro etapas
- Em LangGraph: extrair, buscar, comparar e decidir. Cada etapa grava o que fez e quanto tempo levou.
- Fila de revisão
- Divergências vão para uma fila onde o analista aprova ou rejeita com uma nota, que fica na trilha de auditoria.
- Avaliação offline
- Dois conjuntos: formatos conhecidos e formatos nunca vistos (tabelas, texto com números que distraem, respostas em cadeia).
- Demo protegida
- Limite por IP e tamanho máximo de entrada, para uma chave de LLM exposta não virar conta alta.
Arquitetura
Decisões e trade-offs
- Validação fora do modelo
- A regra confere os campos extraídos com o sistema de registro. Valores divergentes ou ausentes seguem para revisão. A avaliação mede se extrações incorretas ainda podem passar pela regra.
- Um baseline sem IA
- A extração por regex serve de referência. A avaliação compara cobertura em formatos conhecidos e inéditos e mede as aprovações indevidas.
Qualidade e operação
- Avaliação comparativa e demo hospedada pendentes de publicação.
- O protótipo inclui testes com cliente simulado. A execução com modelos reais e a tabela comparativa estão pendentes.
Estado e próximos passos
- Publicar a demo e os resultados da avaliação com Claude e GPT ao lado do baseline.
- Ler anexos em PDF com modelos de visão.
Stack
PythonLangGraphFastAPIPostgreSQLReact + TypeScriptDockerCaddyGitHub Actions